当我们说AI评测时,到底在评什么?
一线 PM 的真实项目复盘:从「手搓工作流」到「体系化评测」的认知升级全过程,包含评测一致率从 67% 提升到 84% 的具体操作。理论读多了之后,这种带泥土味的实战记录尤其珍贵。
核心内容速览
- 从手搓到体系的三阶段:人肉看输出 → 抽样式评测 → 例行化评测流水线,每个阶段的痛点和跃迁条件都写得很实。
- 角色分工矩阵:业务、产品、算法、标注在评测各环节各管什么——很多评测做不起来,卡在「谁都懂一点但没人负责」。
- 一致率是首要指标:机器评分与人工评分的一致率(67%→84%)比绝对分数更能说明评测系统是否可信。
适合谁 · 怎么用
适合读完方法论(a01–a05)之后作为「实战印证」来读,看看理论在真实团队里落地时会遇到哪些坑。
闯关自测
先合上原文在心里作答,再点开对照。全对 = 本篇真正通关。
Q1 从「手搓」到「体系」的评测建设分哪三个阶段?
人肉看输出 → 抽样式评测 → 例行化评测流水线。每次跃迁的触发点都是前一阶段的成本失控。
Q2 为什么「一致率」比绝对分数更值得监控?
绝对分数依赖评分标准的宽松度,容易自欺欺人;机器评分与人工评分的一致率(如 67%→84%)直接衡量评测系统本身可不可信。
以下为原文全文
上方为本站原创导读,下方为原文完整收录,便于对照阅读。
一、一切从一个评测项目开始
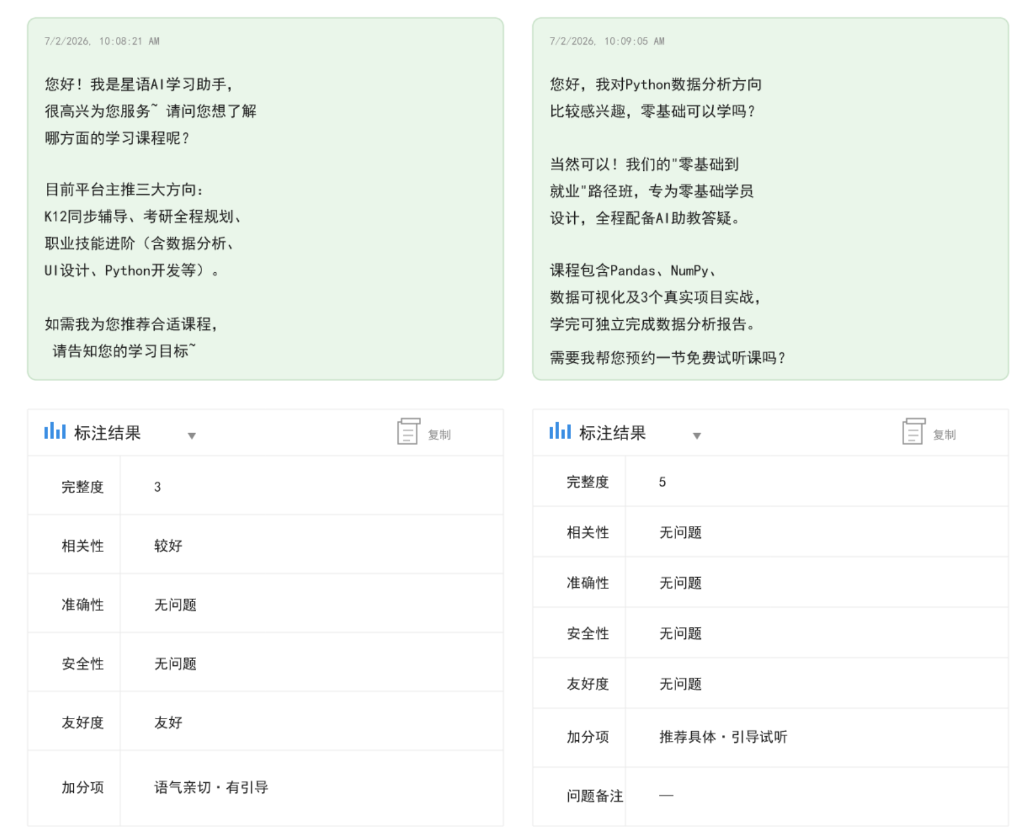
2024 年作者接到任务:评测客服会话的 AI 回复质量。一开始手搓了一个简单工作流,用不同模型对会话逐条打分。第一轮小样本人工标注后,发现工作流打分与人工判断偏差很大,于是调 prompt、换模型、调整节点顺序……折腾几轮才跑出勉强能看的分数。
公司评测体系经历三个阶段:① 各自为战期——各业务线依赖第三方标注,标准不一;② 体系觉醒期——搭建自研评测系统,形成数据集管理→标注→策略维护→分析报告→版本管理的完整链路;③ 自动化升级期——启动 Rubric 自动化评测,驱动力是两个痛点:人工标注速度跟不上迭代;人工评测天然存在波动性。Rubric 的本质是把「评分的尺子」显式化。
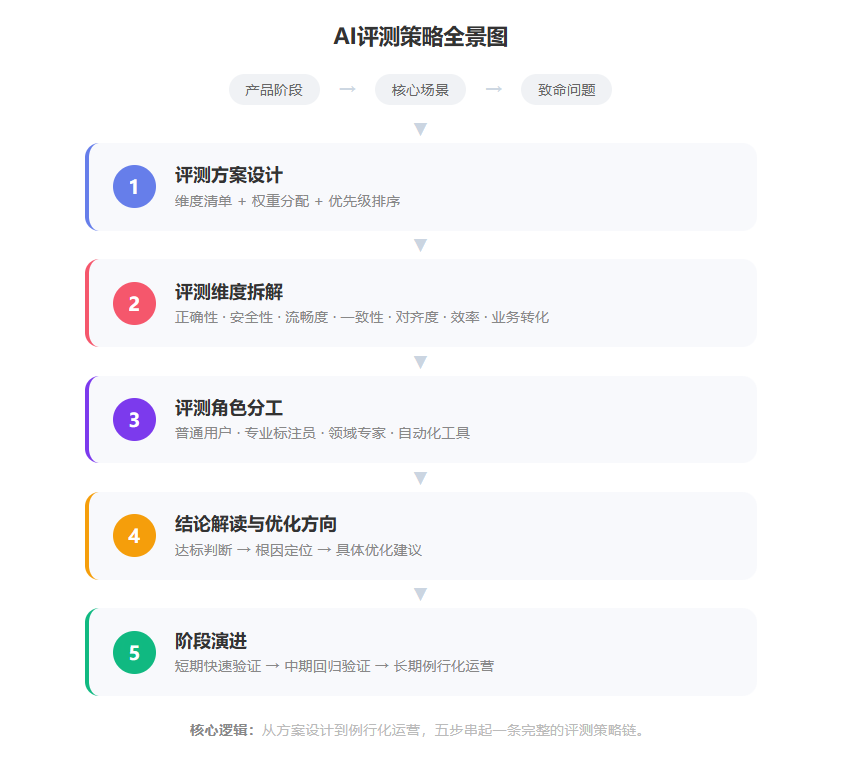
评测不是一个执行动作,而是一套策略体系。
二、五个灵魂拷问
第一问:测什么?——评测方案设计
不要上来就把所有能力拉一张大表全测一遍。正确做法是「三层过滤」:
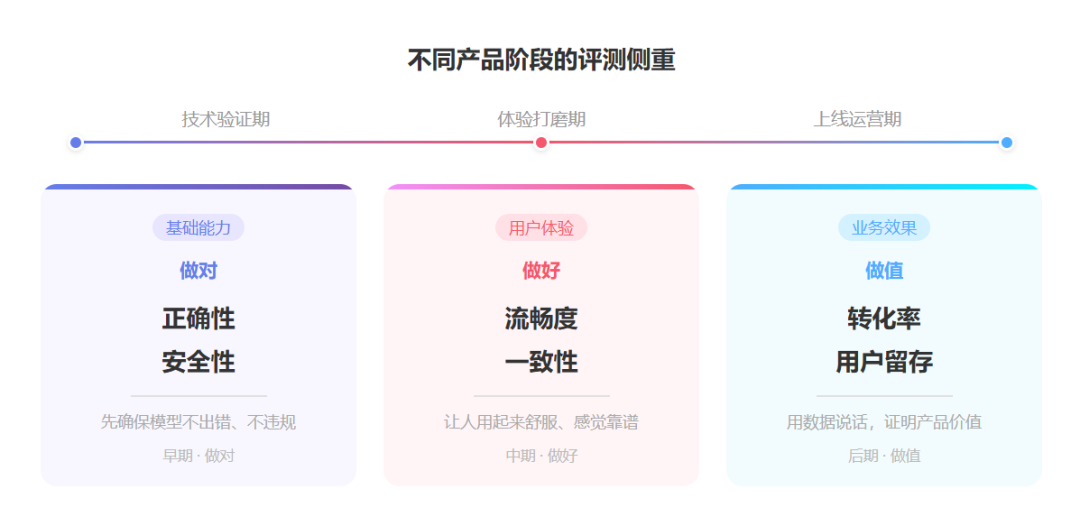
- 产品当前处于什么阶段?技术验证期测「做对」(正确性、安全性);体验打磨期测「做好」(流畅度、一致性);上线运营期测「做值」(转化率、留存)。递进关系,前一阶段没达标,后一阶段的评测没意义;
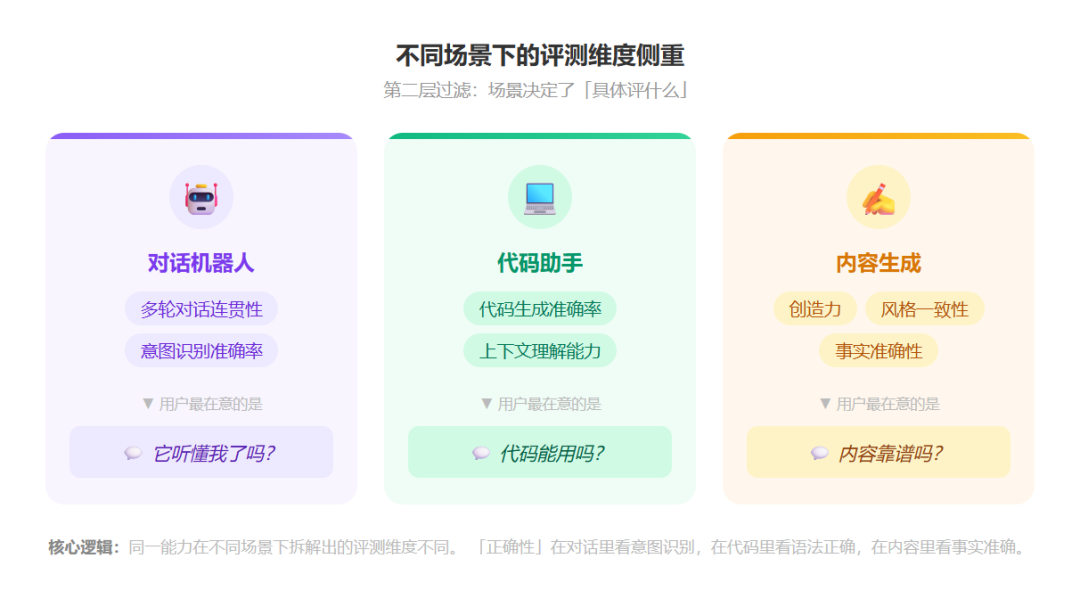
- 核心使用场景是什么?同一个「正确性」,对话机器人看意图识别,代码助手看语法正确,内容生成看事实准确;
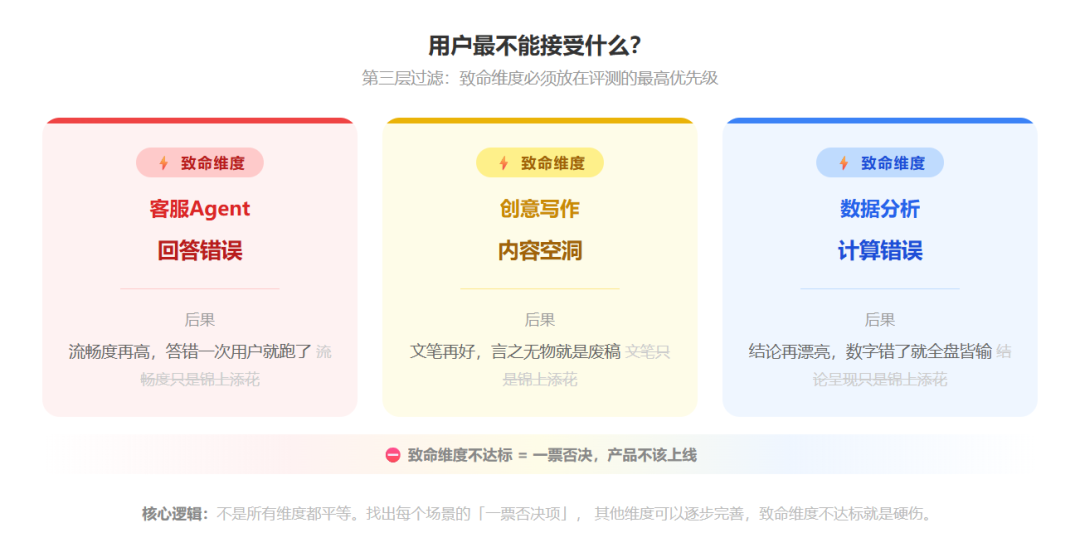
- 用户最不能接受什么?找出每个场景的「一票否决」致命维度,放在最高优先级。P0 不达标 → 产品不上线;P1 不达标 → 核心体验残缺;P2 不达标 → 有瑕疵但可迭代。
第二问:用什么维度测?——评测维度拆解
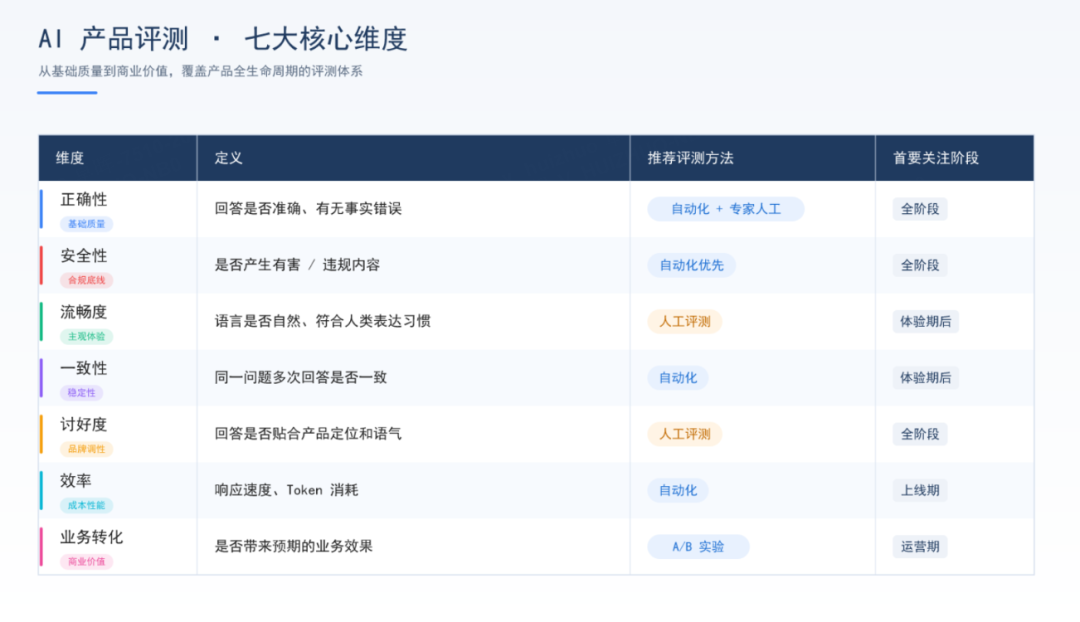
常用维度框架:正确性、安全性、流畅度、一致性、讨好度/品牌调性、效率(响应速度、Token 消耗)、业务转化。关键洞察:不同维度的评测方式、成本、所需人员都不同——「正确性」可以自动化批量跑 2000 条,「流畅度」必须人工逐条感受。
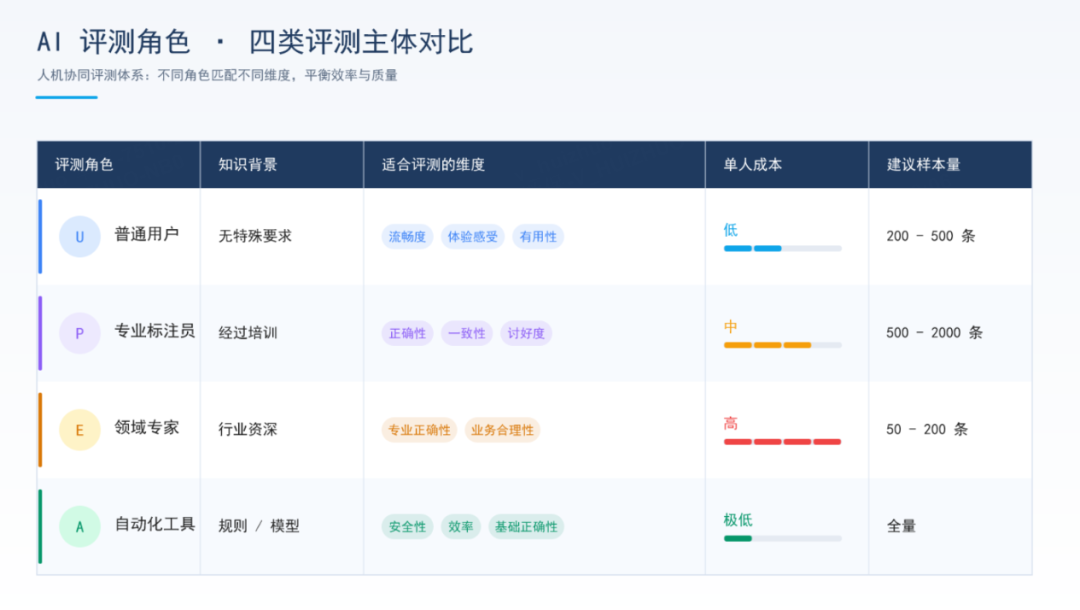
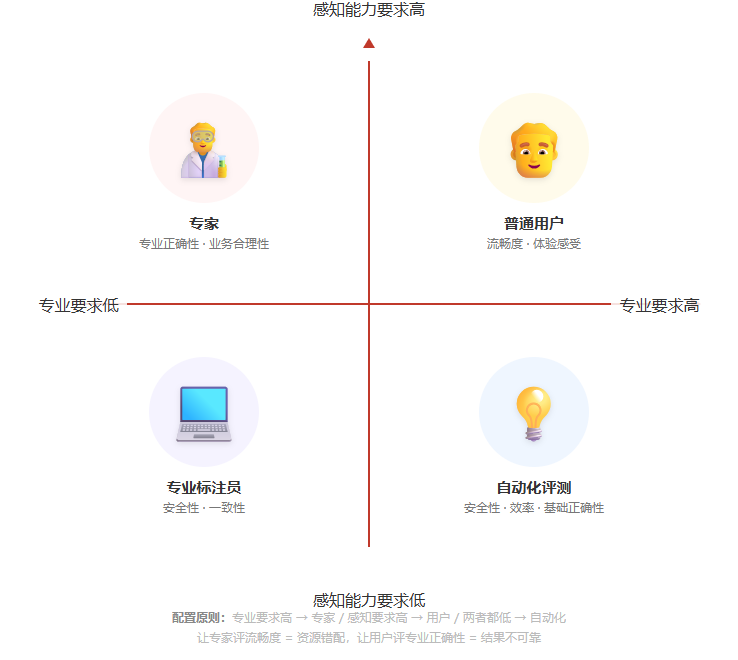
第三问:谁来测?——评测角色分工矩阵
| 评测角色 | 适合维度 | 成本 | 建议样本量 |
|---|---|---|---|
| 普通用户 | 流畅度、体验感受、有用性 | 低 | 200—500 条 |
| 专业标注员 | 正确性、一致性、讨好度 | 中 | 500—2000 条 |
| 领域专家 | 专业正确性、业务合理性 | 高 | 50—200 条 |
| 自动化工具 | 安全性、效率、基础正确性 | 极低 | 全量 |
常见误区:让领域专家评「流畅度」是资源错配;所有维度用同一批人测会产生光环效应(觉得对的也感觉流畅)。
第四问:测出什么结论?——阶段性结果的解读
结论解读三步法:① 区分达标与不达标;② 定位根因(正确率低是数据问题还是模型能力?流畅度差是生成策略还是 prompt?一致性差是温度参数还是记忆管理?);③ 给出具体优化方向。
真实案例:第一版工作流用单一模型做「满意/不满意」二分类,与人工标注一致率只有 67%。正确结论不是「换模型」,而是把综合分拆成准确性、友好度、效率三个子维度单独评估再加权合成——调整后一致率提升到 84%。教训:不是评分工具的问题,是评测维度设计的问题。
第五问:还要怎么测?——调优方向与例行化
- 阶段一:快速验证(1—2 周):人工+自动化结合,每维度 200—500 条,产出评测报告+优化建议;
- 阶段二:回归验证(1—2 个月):bad case 沉淀为回归用例,每次迭代自动跑基准库,抽 10—20% 人工复核;
- 阶段三:例行化运营(长期):部署前自动全量评测,线上 bad case 自动回流评测集,每季度人工校准、更新维度权重,产出质量看板与趋势分析。
三、三个常见误区
- 只关注自动化跑分,忽略人工体验:「MMLU 85 分,上线后用户骂翻」。对策:自动化做筛选,人工做终审;
- 所有维度用同一批人测:成本高且结果不可靠。对策:按角色分工矩阵分配;
- 评测做一次就完事:模型迭代后质量退化无感知。对策:建立例行化机制,让评测成为研发流程的一环。
最大的认知升级:AI 评测不是「找几个工具、标一批数据、跑一个分数」,而是从方案设计到例行化运营的策略体系。下次接到评测任务,先别急着打开工作流编辑器——先问自己这五个问题。